本站点使用Cookies,继续浏览表示您同意我们使用Cookies。 Cookies和隐私政策>

简体中文
首页 > 关于我们 > 新闻中心 > 浪潮信息“AIStation:智能体时代的Token工厂”入选AIIA先锋案例

浪潮信息“AIStation:智能体时代的Token工厂”入选AIIA先锋案例

2026-10-19

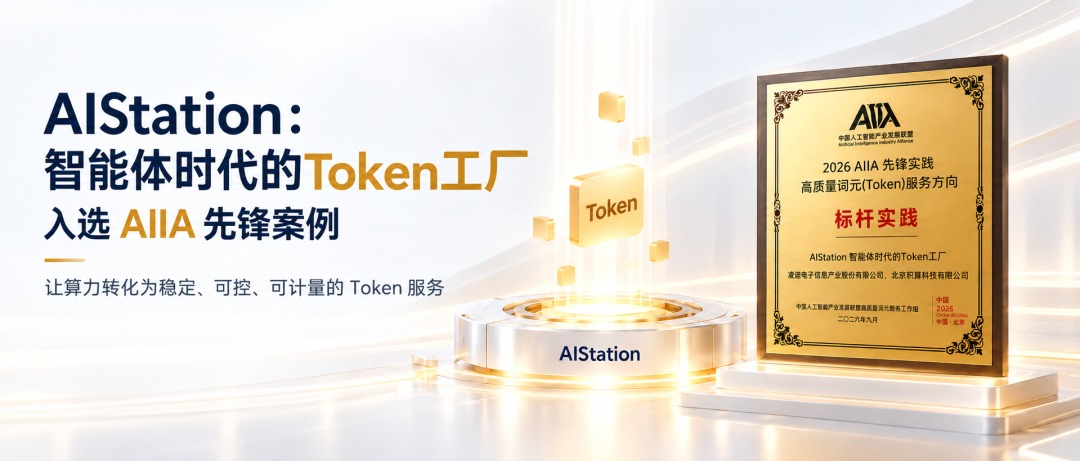
近日,中国人工智能产业发展联盟(AIIA)人工智能先锋案例评选结果公布。浪潮信息联合北京积算科技有限公司(以下简称“积算科技”)申报的“AIStation:智能体时代的Token工厂”成功入选。本次评选由AIIA模型服务(MaaS)工作组、词元服务工作组组织,重点考察案例的技术创新、模式创新及应用成效。

此次入选,是浪潮信息AIStation在异构算力管理、模型服务和Token运营等方面应用实践的体现。随着大模型和智能体应用逐步深入企业业务,企业不仅需要部署算力和模型,还需要统一管理模型调用、资源分配与Token用量。AIStation围绕算力资源池化、模型服务交付和Token运营管理提供一体化支撑,帮助企业提升AI算力资源使用效率和模型服务管理水平。

AIStation 入选 AIIA 先锋案例海报.jpg

01 企业用模面临三方面难题:算力利用率低、推理服务不稳、Token核算难

随着大模型与智能体加速进入企业业务场景,Token调用需求持续增长。据《2026年中国人工智能计算力发展评估报告》,智能体正以乘数效应推动Token消耗激增,2026至2030年中国Token消耗量复合增长率达3499.3%。随着应用规模扩大,企业在算力资源利用、服务稳定性和成本管理等方面面临新的挑战。

一是算力资源利用率不高。大模型推理业务负载随调用量和并发需求动态变化,算力资源配置与实际负载难以实时匹配。部分推理服务需要预留较多GPU资源应对业务高峰,低负载时又容易出现算力闲置;加之模型部署和日常运维需要持续投入人力,进一步增加了企业的算力使用与运营成本。

二是推理服务稳定性不足。智能体应用涉及多轮推理、长上下文处理与高并发调用,业务高峰时容易出现响应延迟增加、吞吐性能下降等问题。模型部署与推理资源调度相对分散,难以及时响应负载变化,影响模型服务的连续性和稳定性。

三是Token消耗难以核算。企业内部模型与API服务分散,Token用量、资源配额和计量计费缺乏统一管理,不同部门、业务和用户的资源消耗难以准确统计,增加了企业用模成本核算和精细化运营的难度。图片

02 从算力到Token:AIStation全链路服务体系的构建与创新

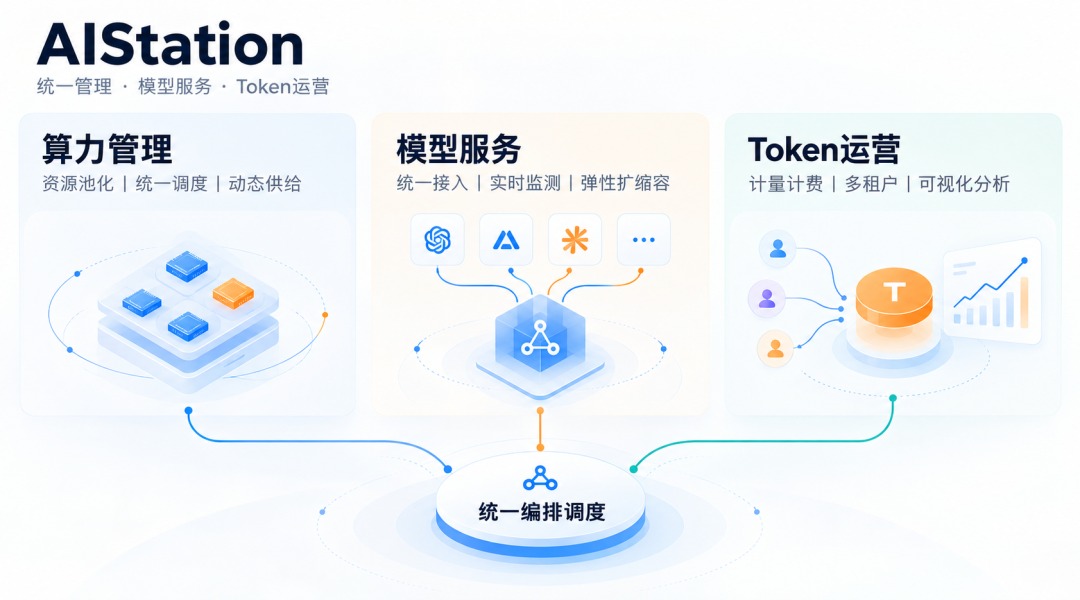
AIStation此次入选,核心在于从底层算力调度到上层Token运营的技术创新与模式创新。面对企业规模化用模需求,浪潮信息AIStation围绕算力资源管理、模型服务和Token运营持续完善产品能力,支持多元异构算力统一纳管和调度,为企业提供统一的AI算力与模型服务管理平台。

在算力管理方面,AIStation支持异构算力资源池化管理,通过GPU资源切分、统一调度等能力,实现算力资源按需分配;结合不同业务负载和资源使用情况,动态调整算力供给,减少低负载时的资源闲置,提高GPU资源利用效率。

在模型服务方面,AIStation支持主流大模型的统一接入、部署与API服务管理,并基于首字延迟(TTFT)、Token吞吐量(TPS)、并发数及GPU利用率等指标,对推理服务进行实时监测与弹性扩缩容,根据业务负载变化动态调整推理资源,保障模型服务的稳定运行。

在Token运营方面,AIStation提供统一模型服务入口,支持Token用量统计、计量计费、资源配额及多租户权限管理,并通过可视化监控与分析,帮助企业掌握资源使用、模型调用和服务运行情况,实现Token服务的精细化运营。

目前,AIStation已支持30余种异构芯片统一纳管,兼容Qwen、Kimi、DeepSeek、GLM等百余种开源模型,为企业构建统一、可管理的Token服务体系提供支撑。

AIStation 三大能力架构示意图.jpg

03 标杆应用实践:积算科技实现万亿级Token规模化运营

作为此次入选案例的落地验证,积算科技的实践展现了服务的商业价值与可复制性。积算科技基于浪潮信息AIStation构建Token服务平台,统一管理底层算力资源、模型部署和API服务,面向企业、科研机构及开发者提供大模型调用服务。

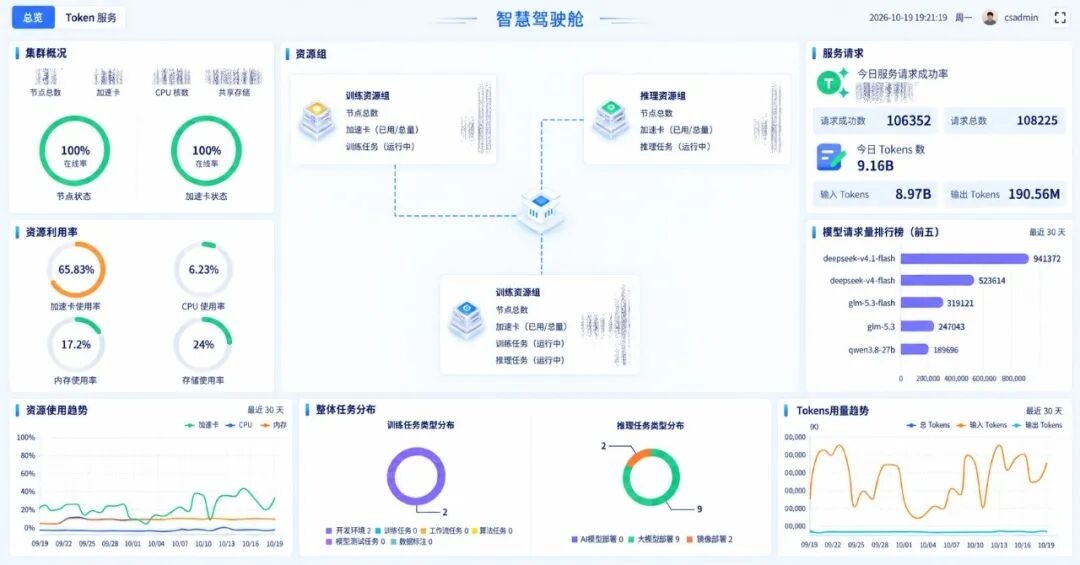
该平台自2026年4月上线以来,累计Token调用量突破万亿,调用成功率保持在95%—99%,注册用户超过4000人,服务覆盖企业、教科研、公共事业及个人开发者等群体。在实际运营中,平台通过统一算力资源管理、模型服务和Token用量统计,支持不同用户和业务场景下的模型调用与资源分配,验证了“Token工厂”模式在规模化运营中的可行性与应用价值。

AIStation 智慧驾驶舱监控界面.jpg

目前,平台在支持主流生成式大模型之外,已率先接入Jev类决策模型,实测处理速度最高可达参测大语言模型的170倍。通过将高频判断交由决策模型,复杂推理交由生成式大模型,平台实现了多模型协同分工,有效降低了智能体运行的等待延迟与计算开销,进一步验证了AIStation在统一纳管多元模型、优化企业用模成本方面的实际成效。

未来,浪潮信息将持续完善AIStation在异构算力管理、模型服务部署、Token运营和智能运维等方面的能力,携手产业伙伴拓展实际应用场景,为企业规模化部署和运营大模型、智能体应用提供更加高效、可靠的AI计算平台支撑。


售前咨询

售后服务

意见反馈

回到顶部

回到顶部

收起
回到顶部 回到顶部
请选择服务项目
售前咨询
售后服务
访问 AIStore

扫码访问AIStore