本站点使用Cookies,继续浏览表示您同意我们使用Cookies。
Cookies和隐私政策>



title
-
元脑®通用服务器>>机架&塔式服务器
 第七代服务器 第六代服务器整机柜服务器高密度服务器
-
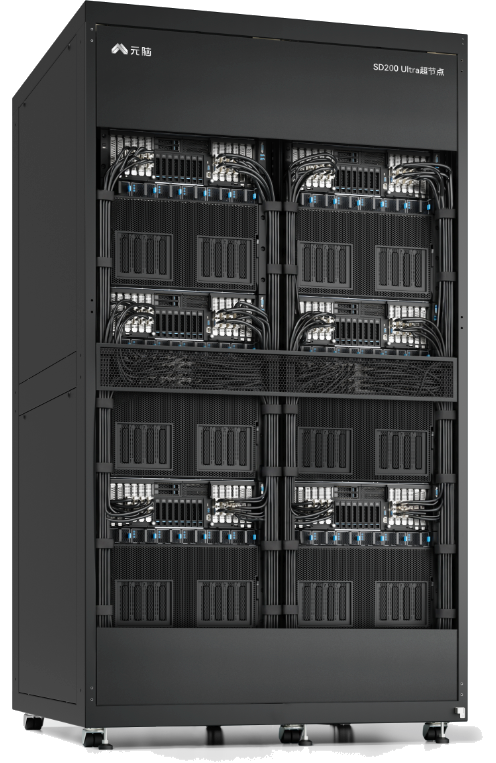
超节点服务器GPU服务器管理平台
-
K1 Power K系列
-
元脑®存储>>高端存储中端存储入门级存储数据管理与保护SSD硬盘扩展柜
-
元脉网络>>AIGC网络 交换机 软件数据中心 核心交换机 汇聚/接入交换机 软件园区网络 交换机 无线局域网 路由器 软件安全及运维 防火墙 综合运维软件
-
方案产品>>SAP HANA 认证产品VMware vSAN超融合认证产品一体机产品
-
数据中心解决方案数据中心产品系列制冷产品系列配电产品系列机柜及通道产品系列动环监控产品系列液冷产品系列
-
服务器管理平台>>服务器管理套件基础设施管理平台服务器固件在线仓库
成为合作伙伴>>
浪潮信息致力于构建全球化的智慧计算生态,愿与合作伙伴从业务、资源、战略上全面聚合,共同推动客户数字化转型。
查找合作伙伴>>
查找当地经销商联系方式或者提交需求表单与经销商联系沟通。
联合创新平台>>
融汇认证与体验,激发创新力量,助力合作伙伴成长,为客户提供卓越体验和服务,共创业务增长!
客户测试中心>>
· 产品远程测试>>
AI创新中心>>
为全球客户提供先进AI算力、完整软件框架和成熟Demo演示。
联合伙伴开展技术和产品验证,推动边缘计算技术创新和应用。
技术博客
信任中心
联系我们


 访问 AIStore