随着大模型进入长上下文、多轮会话和Agent工作流,需要保留和复用的KV Cache正在快速增长,而GPU HBM、主机内存以及计算节点本地SSD的容量,并不会随着上下文需求同步增长。如何在不过度增加高成本内存、不绑定GPU节点扩容的情况下,为更多上下文提供高速缓存空间,正在成为大模型推理基础设施需要解决的新问题。
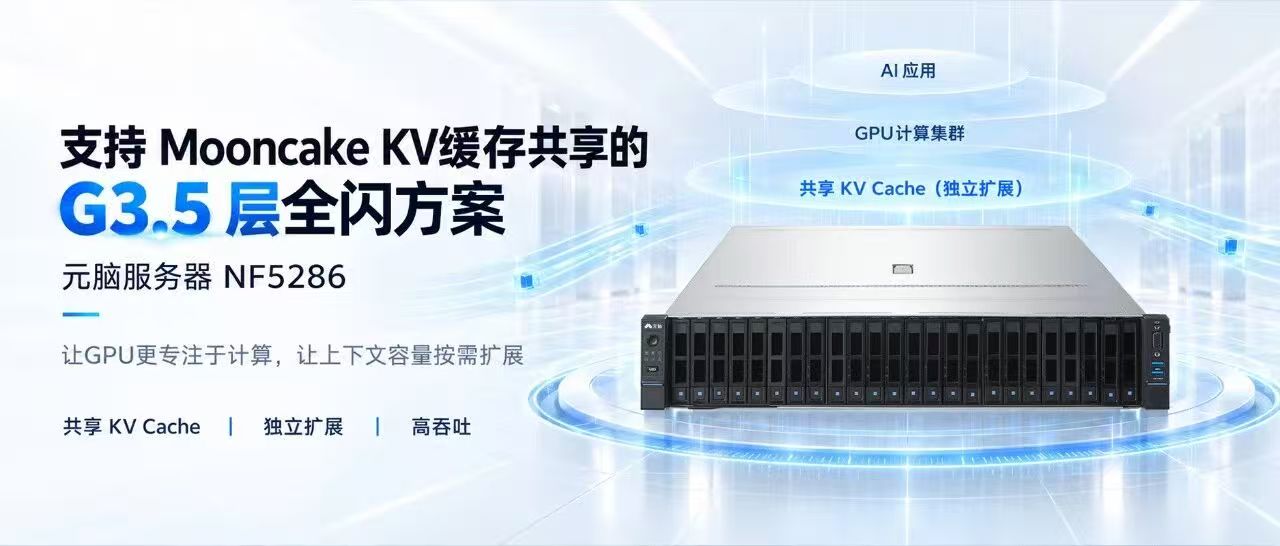
元脑服务器面向大模型推理场景,推出支持Mooncake KV缓存共享的G3.5层全闪方案。方案以元脑全闪服务器NF5286为核心,与Mooncake缓存组件、推理框架的缓存感知调度协同,为推理集群提供独立于计算节点、可按业务需求单独规划的KV Cache共享空间。当上下文需求增长时,可以单独扩展缓存资源;当GPU节点扩容、调整或维护时,缓存资源也不必完全随计算节点变化。
目前,该方案已完成测试验证。在本轮160K长上下文测试中,G3.5层全闪服务器方案的TTFT和KV Cache命中率达到与内存充足路径相近的水平;按本轮配置测算,共享全闪缓存的存储成本约为内存方案的1/20,为进一步进入真实业务场景验证提供了基础。
01 上下文持续增长 需要突破单机资源边界
大模型推理正在经历一个重要变化:上下文正从一次请求中的临时数据,逐步变成推理系统中需要持续管理和反复利用的重要资源。
随着上下文从数万Token走向十万甚至百万Token,用户与模型之间的交互从单轮问答延伸到长时间会话;在Agent场景中,一个任务还可能持续经历规划、检索、工具调用、执行和迭代等多个阶段。
这些过程中会产生大量KV Cache。如果已经计算过的上下文能够被持续保留并有效命中,就可以减少重复Prefill,把更多GPU计算资源留给新的Token生成和任务执行。
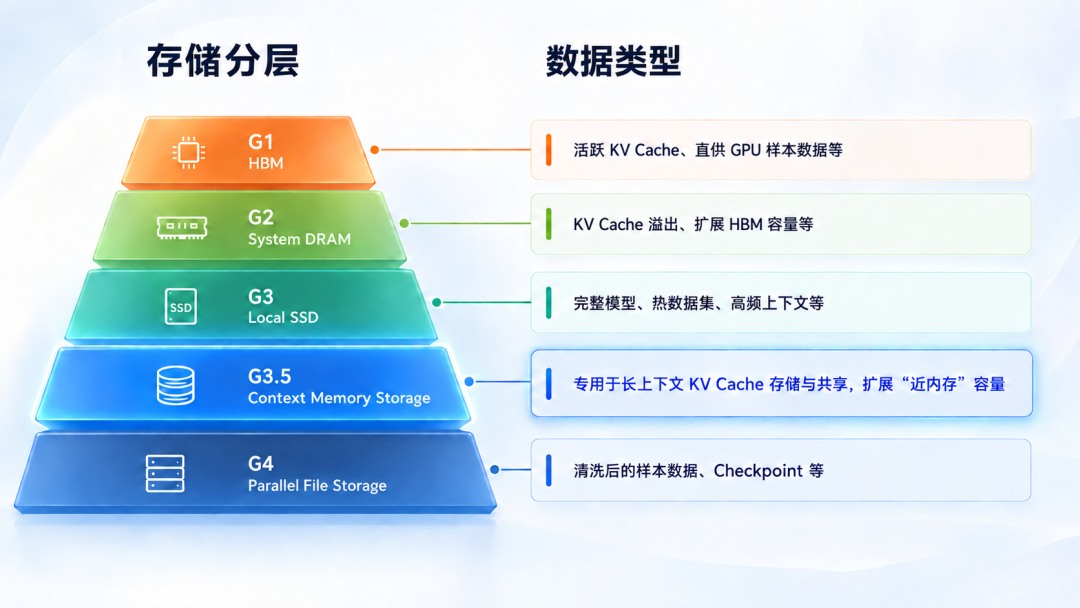
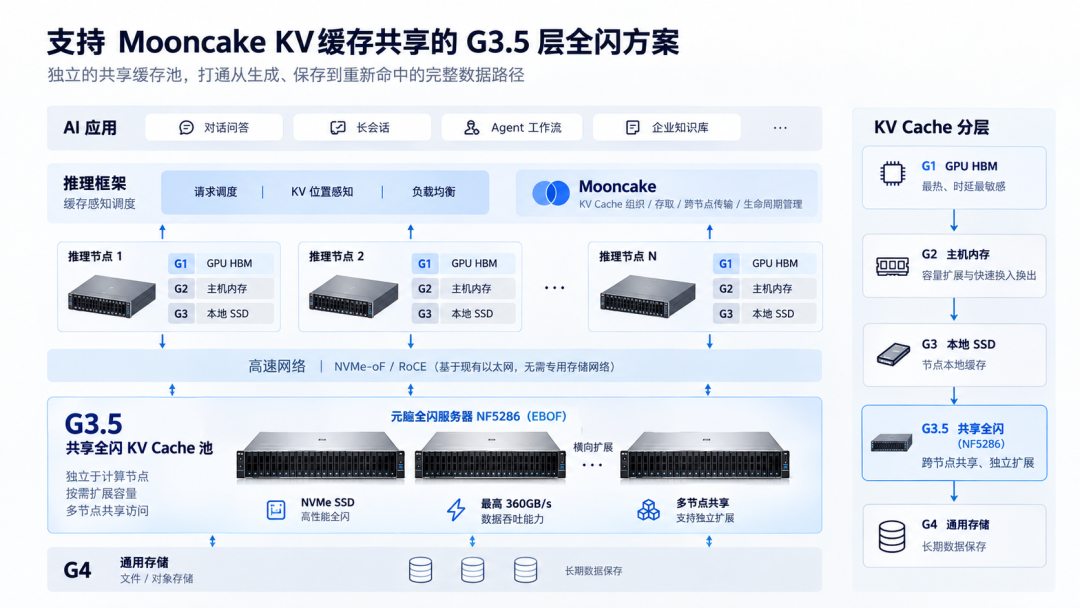
从现有推理缓存体系看,KV Cache正在形成明显的分层:G1为GPU HBM,承载最热、时延最敏感的KV;G2为主机内存,承担容量扩展与快速换入换出;G3为计算节点本地SSD,进一步扩大缓存空间;G4则是共享文件、对象等通用存储,更多承担长期数据保存。
随着需要保留的上下文持续增加,问题开始集中在G3这一层。
本地SSD能够利用GPU服务器已有资源,并可通过缓存软件实现一定程度的跨节点复用,但其物理资源仍然属于单台计算节点:缓存容量受到服务器盘位、PCIe资源等条件限制,扩展缓存往往需要同步调整GPU服务器;节点下线时,其本地缓存资源也会随之受到影响。
这意味着,算力扩展与缓存扩展开始出现不同的节奏。
有时,客户并不缺少GPU计算能力,只是希望保存更长时间、更多用户或者更多Agent任务的上下文;如果为了增加缓存容量而同步增加GPU服务器,资源配置就容易出现不匹配。
因此,在G3本地SSD与G4通用共享存储之间,需要增加一层既具备高速访问能力,又能够跨计算节点共享、独立扩展容量的缓存资源。在推理存储分层中,可以将这一位置理解为G3.5层。它不替代G1、G2对最热KV Cache的承载,也不承担G4长期数据持久化的职责,而是重点承载已经计算完成、近期仍有较高复用价值、容量较大且需要跨节点访问的KV Cache。
02 元脑服务器推出支持Mooncake KV缓存共享的G3.5层全闪方案
元脑服务器推出支持Mooncake KV缓存共享的G3.5层全闪方案,方案通过元脑全闪服务器NF5286将NVMe闪存资源从GPU计算节点中独立出来,基于NVMe-oF和RoCE网络向多个推理节点提供高速共享访问;软件侧结合Mooncake完成KV Cache的组织、存取与跨节点传输,并由推理框架根据缓存状态进行放置与调度,共同打通KV Cache从生成、保存到重新命中的完整数据路径。
整个方案并不改变现有推理系统的缓存层级,G1 GPU HBM和G2主机内存继续承载最热、访问最频繁的KV Cache,G3本地SSD可以保留节点本地缓存,新增的G3.5共享全闪层则承载容量更大、具有跨节点复用价值的上下文,在现有体系中补上一层可共享、可扩展的高速缓存容量。
硬件层面,元脑全闪服务器NF5286采用EBOF技术架构,将NVMe SSD从GPU服务器内部独立出来,通过NVMe-oF向多个推理节点提供对等访问。EBOF-NF5286可提供最高360GB/s数据吞吐能力,基于现有以太网/RoCE网络即可接入推理集群,无需为KV Cache单独建设专用存储网络。在这一架构下,GPU服务器主要承担模型推理计算,共享全闪服务器负责承载大容量KV Cache及相应数据访问。增加缓存容量时,可以扩展共享闪存资源,而不再完全依赖GPU服务器内部盘位和PCIe资源。
软件层面,Mooncake负责KV Cache的组织、存取、跨节点传输及生命周期管理,将底层共享全闪资源转化为推理框架可以调用的缓存空间;推理框架结合KV Cache的位置与命中状态进行缓存感知调度,使新的推理请求能够优先复用已经计算完成的上下文。计算、网络、共享闪存、Mooncake和推理框架共同打通从KV生成、写入、保存、检索到重新加载的数据路径,实现KV Cache在不同推理节点之间的共享和复用。
这一变化带来三方面的直接收益:
●缓存容量可以独立于GPU算力扩展。 当GPU计算资源仍有余量,而长会话、Agent任务或并发用户增加带来更多上下文保留需求时,可以通过增加共享全闪容量扩展KV Cache空间,不必为了缓存容量同步增加GPU服务器,使计算和缓存能够按照不同的业务增长速度分别规划。
●KV Cache从单节点资源转变为集群共享资源。已经计算完成、近期仍可能再次使用的上下文,可以保存在独立缓存层并由多个推理节点访问。GPU节点发生扩容、调整或维护时,缓存资源也不必完全跟随单台服务器变化,为跨节点复用和更灵活的推理调度提供基础。
●GPU服务器可以更加聚焦推理计算。大容量缓存和部分闪存数据服务由独立设备承载后,可以减少对GPU服务器内部盘位、PCIe以及相关主机资源的依赖,让计算节点和缓存资源分别围绕算力与容量需求进行配置。
这也是G3.5层共享缓存与传统增加本地SSD的核心区别:它不是简单增加一块更大的存储空间,而是通过软硬件协同,把KV Cache从单机内部资源扩展为可以跨节点访问、独立扩容和统一调度的集群级资源。
03 G3.5全闪方案实测:高并发下保持接近内存路径的响应表现
当并发没有触碰系统拐点时,介质差异并不显眼;一旦越过拐点,缓存命中和尾延迟会迅速改写推理体验。
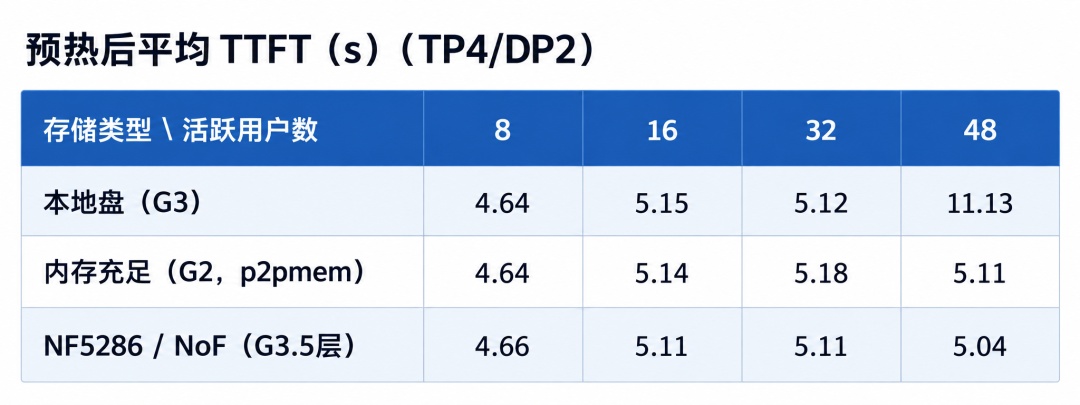
浪潮信息基于某万亿参数MoE大模型,在160K长上下文场景中,对多主机、多并发推理集群进行了Mooncake集成路径测试。本轮采用双主机、16张算力卡环境,开启DP Attention后,采用TP4/DP2,固定每节点QPS=8,分别设置8、16、32、48个活跃用户,对比本地盘、内存充足和G3.5层全闪方案三种路径。为保证对比可运行,本轮本地SSD场景同样分配了250GB×2内存,避免因内存配置差异影响测试结果。
实测观察:在8-32个活跃用户的测试范围内,三种缓存路径的平均TTFT都处在4.64-5.18秒之间,差异很小。随着测试负载提升至48个活跃用户,G3.5层全闪方案平均TTFT为5.04秒,内存充足路径为5.11秒,本地盘路径为11.13秒,并在各轮6.65-17.56秒之间大幅波动。
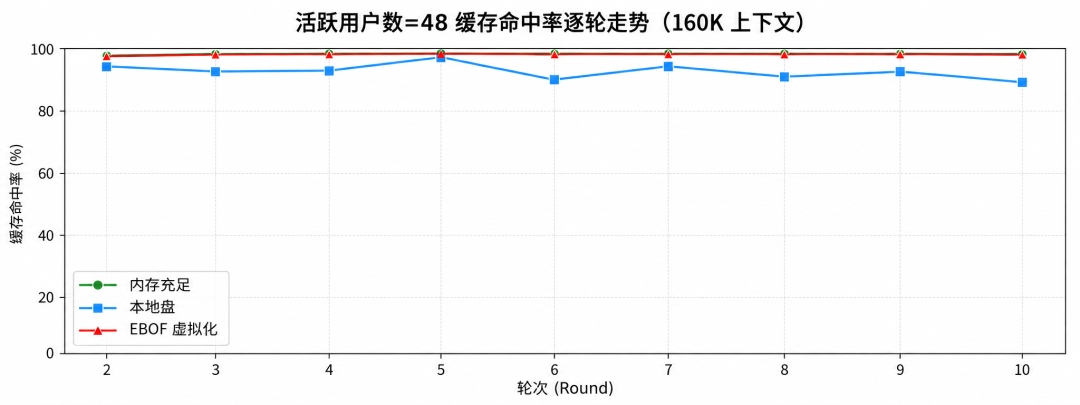
进一步观察48用户负载下的尾延迟和缓存命中情况,48用户下,本地SSD路径P99 TTFT达到53.76秒,是自身均值的4.8倍;G3.5层全闪方案为6.57秒,内存充足方案为6.63秒。与此同时,本地SSD路径KV Cache命中率下降至92.81%,G3.5层全闪方案和内存充足仍分别保持98.44%和98.45%。对于160K长上下文而言,缓存命中率的变化不仅影响数据读取,还可能决定一部分长前缀是否需要重新执行Prefill,因此最终会反映到TTFT和尾延迟表现上。
本轮测试说明,在当前模型、软件栈和测试负载下,G3.5层全闪方案已经能够与Mooncake及推理框架完成有效协同,并保持接近内存充足路径的TTFT和KV Cache命中表现。
对于上下文需求增长快于算力需求、GPU节点需要灵活调整的集群,这套G3.5层全闪方案提供了一条值得优先评估的路径:让共享缓存按业务需要建设,让GPU节点更专注于计算,也让客户能够以真实服务指标决定扩展节奏。
目前,元脑服务器大模型推理共享KV Cache全闪方案已可面向长会话推理、Agent工作流以及Prefill/Decode分离等场景开展业务验证,浪潮信息诚邀有长上下文、高并发推理需求的客户,结合自身模型与软件栈开展联合测试。浪潮信息将持续与Mooncake等缓存组件及主流推理框架协同适配,扩展G3.5层全闪服务器方案的集成路径与部署形态,把上下文容量从单机约束中进一步释放出来,为规模化AI推理提供更灵活的扩展空间。



 第七代服务器



 访问 AIStore