本站点使用Cookies,继续浏览表示您同意我们使用Cookies。 Cookies和隐私政策>

简体中文
首页 > 关于我们 > 新闻中心 > 浪潮信息发布元脑InManage Ultra,打造AI超节点系统级智能运维平台

浪潮信息发布元脑InManage Ultra,打造AI超节点系统级智能运维平台

2026-10-26

随着AI算力规模持续扩张,AI超节点正成为智算中心的重要组成单元。AI超节点将大量加速卡整合为统一计算域,计算、互连、供电、散热等各子系统高度耦合,任何细微异常,比如网络链路降速或单个GPU异常,都可能会拖慢甚至中断AI任务。因此,智算中心的运维管理对象从单台IT设备,升级为一整套复杂的超节点系统,需要掌握超节点整体运行状态,及时发现跨模块的异常与性能风险,并实现协同处置。

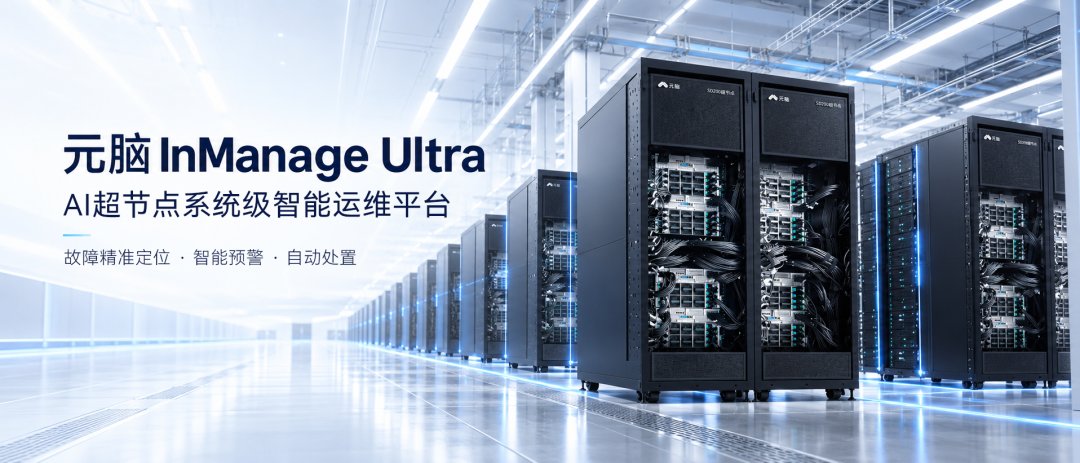
对此,浪潮信息推出元脑InManage Ultra智能运维平台,面向智算中心运维场景,强化AI超节点系统智能运维能力,构建覆盖计算、网络、供电、液冷及软件环境的统一运维体系。元脑InManage Ultra整合带内与带外联合监控数据,可实时关联分析超节点系统中计算、网络、供电、液冷及软件环境的运行状态,依托内置上千条硬件告警定义和百余个预警模型,GPU内核错误、网络异常等典型故障秒级发现,并对GPU热降频、PCIe链路降速等潜在性能风险进行提前预警,保障超节点长期稳定运行。


元脑 InManage Ultra 产品宣传图.jpg


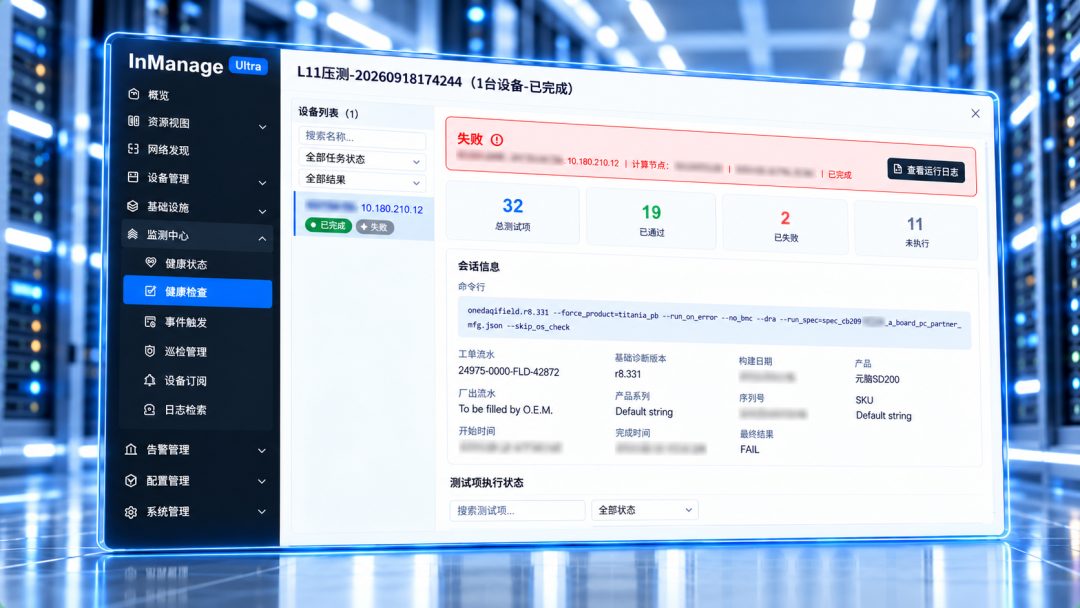
目前,该平台已在多个智算中心部署应用。在元脑SD200等AI超节点的交付过程中,平台支持L11级整机柜压力测试,可验证系统上线前的稳定性;在日常运维中,单柜全量检测最快仅需3分钟,有效提升超节点的运维效率,降低设备故障及性能异常对AI任务运行的影响。


01 带内与带外数据统一观测,实现故障快速精准定位

超节点运行过程中,系统稳定性可能会因计算负载、计算、互连、散热等不同模块共同影响,单一指标异常往往难以直接对应故障原因。例如,GPU利用率突然大幅下降既可能源于业务负载变化,也可能是互联链路异常,或液冷散热异常引发的性能波动。因此,要判断超节点设备是否运行稳定,需要结合设备健康、链路性能和供电散热状态综合分析。但传统运维中,运维人员要通过带内数据获取操作系统、业务负载和应用运行情况,通过带外数据了解各台硬件设备、固件以及供电、散热等状态。两类数据分散在不同管理界面,运维人员发现异常后,往往需要跨系统比对,才能逐步定位问题根因,耗时久。

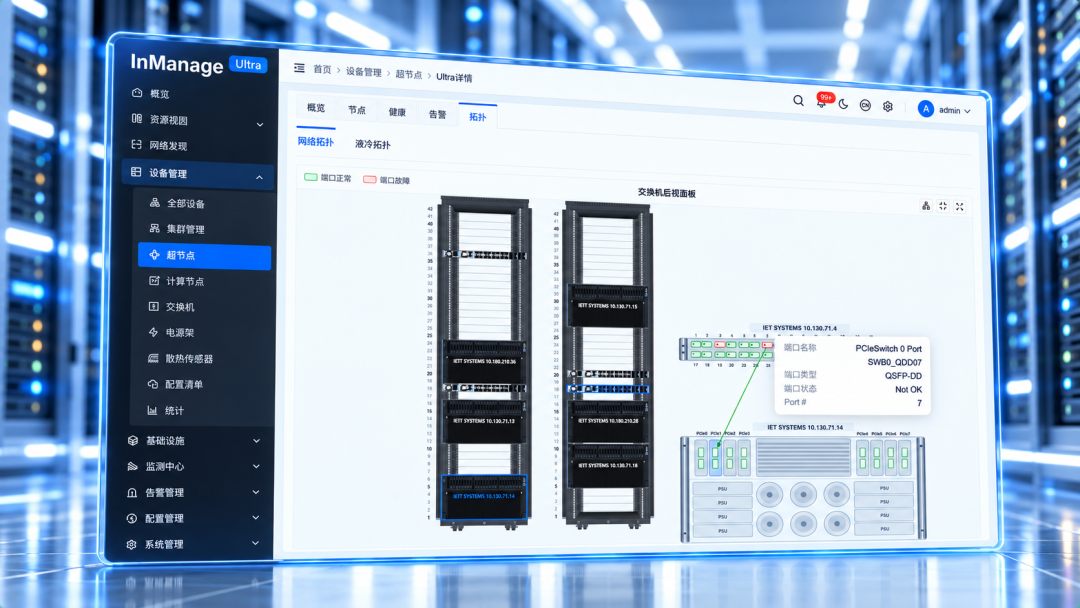
元脑InManage Ultra通过带内与带外联合监控,关联GPU运行状态、链路拓扑与性能、供电及液冷等数据,结合分析结果判断系统运行状况。实际应用中,平台可快速识别异常,将故障根因定位时间由8小时级缩短至0.5小时以内,为缩短平均修复时间(MTTR)提供支撑。目前,平台可识别GPU、液冷CDU、电源Power Shelf等关键部件的15类现场故障,并将相关故障精准定位至具体部件,减少逐项排查的时间。

对于需要快速响应的异常情况,平台还可根据监测结果自动触发相应保护措施。在液冷超节点运行过程中,通过节点级、机柜级和环路级三级漏液监测,快速定位异常范围,并可在发现漏液故障10秒内自动启动安全关机、关闭电磁阀、隔离节点等保护措施,防止故障影响进一步扩大。


超节点拓扑故障定位界面.jpg


超节点网络拓扑故障根因快速定位


02 百余项预警模型提前识别性能风险,变被动处置为主动预防

超节点智能运维不仅在于故障发生后的快速定位,还在于提前发现可能影响系统性能的异常征兆。据统计,超节点系统中GPU、互联链路和PCIe总线相关故障,分别占故障总数的45.6%、9.2%和10.4%。其中,部分异常在初期并不会导致设备宕机,却可能表现为链路错误持续增长、GPU通信效率下降,导致AI任务运行性能逐步降低。如果未能及时识别这些信号,局部异常可能持续发展,最终影响整体运行效率,甚至造成AI任务中断。因此,需要对超节点关键部件和运行指标进行持续监测,在故障显现或性能明显下降之前识别潜在风险,为提前干预争取时间。

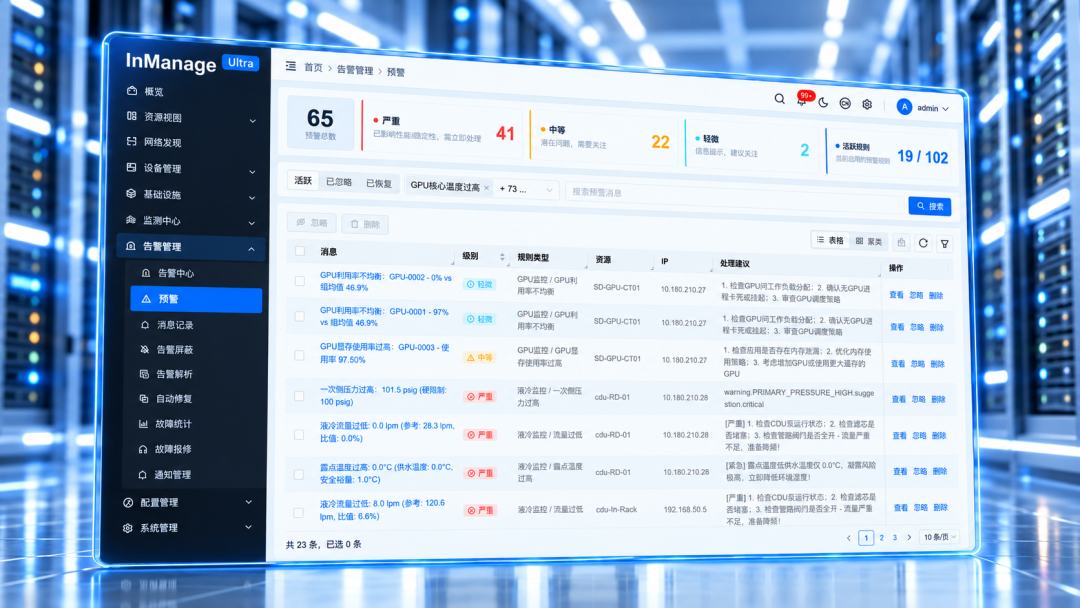
元脑InManage Ultra构建起覆盖GPU、PCIe互连、供电、液冷等各个关键系统的百余项AI预警模型,可根据GPU利用率、负载分布、温度与功耗等多维特征,识别潜在的性能风险,为运维人员提前排查和干预提供依据。其中,针对超节点中GPU的AI预警模型覆盖40多类GPU相关风险,包括PCIe链路降速、重放错误增长、GPU热降频、功率限制和显存高占用等典型问题。针对超节点适配的推理软件栈,平台还可采集AllReduce、AllGather等集合通信指标,辅助分析计算与通信过程中的性能瓶颈。对于发现的慢节点、慢链路等问题,平台可触发预警,并通过预设脚本或工单安排后续处理,减少人工协调和排查工作。


超节点故障风险预警界面.jpg


超节点各类故障风险提前预警


03 整机柜压测验证高负载下协同能力,提升规模部署效率

AI超节点通常以整机柜形式交付,计算、互联、供电和液冷等子系统需要协同运行。单个系统测试正常,并不能替代整柜级的各模块协同运行测试。GPU性能差异、互联异常或供电与散热不匹配等问题,可能在整柜高负载运行时才暴露。如果超节点没有在出厂前就开展整机柜级压力测试,将大大增加现场排障和返工成本,影响业务上线。

元脑InManage Ultra支持L10节点级和L11机柜级压力测试,可在交付前验证计算、互联、供电及液冷系统在高负载下的性能与稳定性,及时发现潜在问题,提升设备一次交付成功率,减少现场调试与返工。针对大规模部署,平台还支持通过配置模板、固件自动升级和版本一致性校验,实现软硬件环境标准化配置与批量部署,最快30分钟完成千柜级系统部署;同时,可通过开放标准接口接入不同品牌、不同型号的设备,并对接云管理平台及AI智能体,支持集中管理与批量运维。


L11 整机柜压测操作界面.jpg


L11级整机柜压测

目前,InManage Ultra已在金融、智驾、电力等行业落地,单一客户管理规模超过10万节点。针对AI超节点计算、互联、供电、液冷等多系统高度耦合的特点,平台将运维管理从单个设备扩展至整套系统,通过交付前的整机柜压力测试、运行中的故障精准定位与性能风险预警,及时发现影响系统稳定性和计算性能的问题,减少单点异常对整体任务运行的影响,保障AI超节点持续、稳定地提供算力服务。

售前咨询

售后服务

意见反馈

回到顶部

回到顶部

收起
回到顶部 回到顶部
请选择服务项目
售前咨询
售后服务
访问 AIStore

扫码访问AIStore